noindexは、ページのソースで name="robots" のmetaタグを探し、あわせてHTTPレスポンスヘッダーの X-Robots-Tag を見れば確認できます。ヘッダー側はソースに出ないため、curl -I か開発者ツールのネットワークで見ます。Googleが実際に読んだかは、Search ConsoleのURL検査で確かめます。robots.txtでクロールを禁止したURLは、noindexを書いてもGoogleに読まれません。
noindexが書かれる場所は2つ
| 場所 | 書き方 | 見える所 | 注意 |
|---|---|---|---|
| HTMLのmetaタグ | <meta name="robots" content="noindex"> | ソース表示・開発者ツール・チェックツール | HTMLしか見ないと、ヘッダー側のnoindexを見落とす |
| HTTPレスポンスヘッダー(X-Robots-Tag) | X-Robots-Tag: noindex | curl -I・開発者ツールのネットワーク | ページのソースには一切出ない。PDFや画像にも付けられる |
判断の軸は「Googleが読めるか」です。noindexはGoogleがページを取得して初めて効きます。だから、ソースに書いてあることと、Googleが読めたことは別に確かめます。なお、robotsのmetaタグは <head> に置くのが基本ですが、Googleは <body> にあっても従うと説明しています。<head> 内でしか受け付けないcanonicalとは扱いが違います。
確かめる順番:5つの手順
1. ソース表示で name="robots" と name="googlebot" を探す
ページを開いてソースを表示し(Windowsは Ctrl+U、Macは Command+Option+U)、ページ内検索で robots と googlebot を探します。content に noindex か none があれば、そのページは検索から外す指示が出ています。none は noindex, nofollow と同じ意味です。
2. レスポンスヘッダーの X-Robots-Tag を見る
ターミナルで下のコマンドを実行します。何も出なければヘッダー側のnoindexはありません。「X-Robots-Tag: googlebot: noindex」のようにボット名が付いていれば、そのボットにだけ効きます。サーバーやCDNの設定で付くことが多く、ソース表示では見つかりません。
3. robots.txtでそのURLを止めていないかを見る
robots.txtでクロールを禁止したURLは、Googleがページを取得できないため、noindexを読めません。Googleは、ほかのページからリンクされていれば、noindexのページでも検索結果に出ることがあると説明しています。noindexを効かせたいURLは、robots.txtでは止めません。
4. Search ConsoleのURL検査で、Googleが読んだかを見る
URL検査にURLを入れ、「ページのインデックス登録」の欄を開きます。Googleがnoindexを読んでいれば、インデックス登録が許可されていない理由として、どこでnoindexを見つけたか(robotsメタタグかX-Robots-Tagか)が出ます。サイト全体はインデックス作成レポートの「noindexタグによって除外されました」で一覧できます。
5. チェックツールで、metaとヘッダーをまとめて確かめる
ディレベースのSEOチェックは、metaタグ(robots・googlebot)とX-Robots-Tagヘッダーのnoindexを見つけると、スコアの下に警告を出します。スコアには混ぜていません。noindexは、ほかの項目をどれだけ直しても検索に出なくなる設定だからです。robots.txtによるクロールの禁止は、この警告では判定していません。
手順1:Googlebotとして取ったHTMLからmetaタグを探す
curl -s -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page | grep -ioE '<meta[^>]*name="(robots|googlebot)"[^>]*>'手順2:ヘッダーのX-Robots-Tagを見る
curl -sI https://example.com/page | grep -i x-robots-tag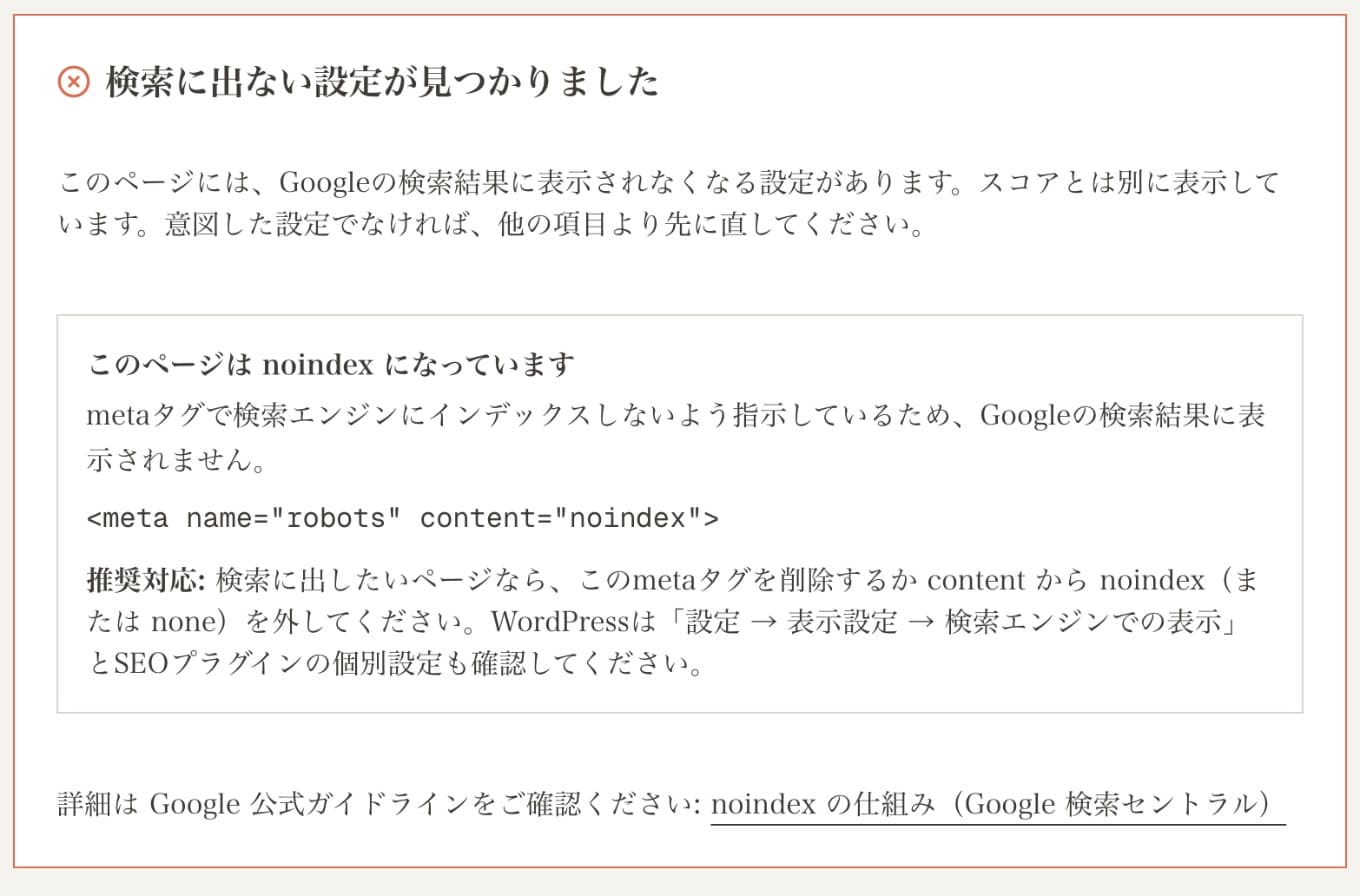
URL検査で出る状態(検出・クロール済みなど)の見分け方は検出 - インデックス未登録の原因と対処に、robots.txtの書き方はrobots.txtの書き方にまとめています。
そもそもnoindexでいいのか:目的別の正しい止め方
Googleは2026年10月21日、「Google検索と共有する情報を管理する」のページを更新し、robotsのmetaタグ・data-nosnippet・X-Robots-Tag・検索の生成AIに関する設定を並べて載せました。何を止めたいかで、使う手段が変わります。noindexを確認する前に、目的に合っているかを見てください。
| やりたいこと | 使うもの | よくある間違い |
|---|---|---|
| ページを検索結果に出したくない | noindex(metaタグかX-Robots-Tag) | robots.txtのDisallow。読まれなくなるだけで、検索から外す指示にならない |
| 検索結果の説明文(スニペット)だけ出したくない | nosnippet・max-snippet、一部だけなら data-nosnippet | noindex。ページごと検索から消える |
| AI OverviewやAIモードへの使われ方を管理したい | Search Consoleの生成AIに関する設定(サイト単位) | noindexで代用する。通常の検索結果からも消える |
| 画像や動画を検索に出したくない | robots.txtでクロールを禁止する(画像・動画は取得できないと登録されない) | ページのnoindex。画像は別のページから使われていれば出ることがある |
| 誰にも見せたくない | パスワード保護か、ページの削除 | noindex。URLを知っていれば誰でも開ける |
| すでに出ている結果を急いで消したい | Search Consoleの削除ツール(一時的)+noindex | noindexだけで待つ。再クロールまで数か月かかることがある |
AIのクローラーごとの止め方(GPTBot・ClaudeBotなど)は、Googleの設定とは別です。AIクローラーにブロックされていないか確かめる方法で整理しています。
実測:このサイトのnoindexのページをGoogleはどう扱ったか
このサイトで検索に出す必要のない4種類のページを、2026年10月26日にソースとSearch ConsoleのURL検査で確かめました。同じnoindexでも、Googleが読んだかどうかは分かれていました。
| ページ | 設定 | URL検査の状態 | 判断 |
|---|---|---|---|
| 新規登録ページ | metaタグ noindex | noindexタグによって除外(最終クロール 2026-08-23) | 意図どおり。何もしない |
| ログインページ | metaタグ noindex | 検出 - インデックス未登録(未クロール) | まだ読まれていないが、検索にも出ていない。何もしない |
| ダッシュボード | metaタグ noindex, nofollow + robots.txtでクロール禁止 | URLがGoogleに認識されていない | noindexは読まれない組み合わせ。いまは問題なし。「ブロックされたがインデックス登録」が出たらDisallowを外す |
| 診断結果の共有ページ | metaタグ noindex, follow(2026-10-23から) | — | robots.txtでは止めない。noindexを読ませるため。SNS用のOGPは残す |
読み取れることは2つです。1つ目は、noindexを書いても、Googleがそのページを取得するまでは何も起きないこと。ログインページは「検出」のまま一度もクロールされておらず、noindexはまだ読まれていません。検索に出ていない以上、困ることはありません。逆に、検索から急いで消したいページでは、noindexだけで待たずに削除ツールを併用します。
2つ目は、ダッシュボードのように「robots.txtで禁止+noindex」にしているページです。Googleの説明どおりなら、このnoindexは読まれません。いまはGoogleがURL自体を知らないので実害はありませんが、外からリンクされてURLだけが検索に出始めたら、robots.txtのDisallowを外してnoindexを読ませる方が確実です。共有ページを検索から外したとき(2026年10月23日)は、この理由でrobots.txtでは止めず、noindexだけにしました。
意図しないnoindexが入る、よくある原因
- テスト環境(ステージング)の設定が、公開後もそのまま残っている。ヘッダーで付けていると、ソースを見ても気づかない
- WordPressの「設定 → 表示設定 → 検索エンジンでの表示」にチェックが入ったまま。SEOプラグインの記事ごとの設定でも付く
- CDNやホスティングの管理画面で、プレビュー用ドメインに付けたX-Robots-Tagが本番のドメインにも効いている
- JavaScriptでnoindexを足したり外したりしている。Googleは描画を必ず行うとは限らないため、元のHTMLの状態を正にする
noindexはメタタグの1つです。title・canonical・OGPなどほかのタグもまとめて確かめる手順はメタタグの確認方法にあります。
関連ツール
出典(2026年10月26日に確認)
よくある質問
noindexをいちばん手早く確認する方法は?▾
robots.txtでDisallowすれば、noindexと同じですか?▾
noindexを外したのに、検索に出てきません。▾
noindexのmetaタグが <body> にあっても効きますか?▾
noindexと一緒にnofollowも付けるべきですか?▾
AI OverviewやAIモードにだけ使われたくない場合もnoindexですか?▾
metaタグとヘッダーのnoindexを、まとめて確かめる
URLを入れるだけで、noindexがあればスコアの下に警告を出します。ソースに出ないX-Robots-Tagも見ます。noindexが無ければ、ほかに直す項目を点数の大きい順に確かめられます。
SEOチェックを試す
この記事を書いた人
今井政和SEOディレクター / フロントエンド開発者
Web業界20年以上の経験を持つSEOディレクター。ディレベースの開発者。WordPress公式プラグイン「ORECTIC SEO CHECK」作者。著書に「三方良しで勝つ 江戸商人に学ぶ現代WEB戦略」。
@imai_directorあわせて読みたい
新規ドメインの検索パフォーマンス分析|表示17,000回・クリック42回のギャップを診断する
技術設定は完璧。なのに42クリック。GA4・ディレベース・GSCを横断し、新規ドメインの表示/クリックギャップを診断するプロセスを共有する。
AI検索の数字に騙されるな|Google I/O 2026の熱狂を原典まで検証する
AI検索をめぐる刺激的な数字を原典まで遡って検証するPrincipalレポート。引用効果+35%の因果の留保、CTR下落率の実数と幅、GSC匿名化の罠を解き、数字に騙されない判断軸を示す。
AI Overview対策で何をチェックすべきか|AIO引用される条件とSEO診断項目
AI Overview(AIO)に引用される条件と、SEO診断で確認すべき項目を30万URL分析等の外部データで検証。構造化データ実装率約3倍・E-E-A-T・コンテンツ明瞭さがAI引用の主要因。AIO時代のSEOチェック項目。
検出 - インデックス未登録の原因と対処|新しい記事がクロールされない時の確認手順
GoogleがURLを見つけたもののクロールを後回しにした「検出 - インデックス未登録」。似た3つの状態の見分け方と、サイトマップ・リンク経路・登録リクエストの確かめ方を、新しい記事が2週間クロールされなかった実例で解説します。